Immagine
GPT Image 2.5 Sunburst Text to Image Varianti: 4
≈ 0,054 $
54 crediti API
Nessuna corrispondenza. Prova “video”, “FLUX” o “webhooks”.
Caricamento dei modelli…
openai/gpt-image-2.5/flare/text-to-image
# Run the model; wait up to 20 s for the finished result in the same call
curl -X POST "https://api.doitong.com/v1/run/openai/gpt-image-2.5/flare/text-to-image?wait=20" \
  -H "Authorization: Bearer $DOITONG_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "prompt": "A handwritten recipe card titled \"Apple Pie\" on a wooden kitchen table, neat cursive ingredient list, a slice of pie on a plate beside it, cinnamon sticks, warm afternoon light, photorealistic.",
    "quality": "medium"
  }'

# Still "queued" or "running"? Poll with the id from the response:
curl "https://api.doitong.com/v1/requests/REQUEST_ID?wait=20" \
  -H "Authorization: Bearer $DOITONG_API_KEY"
const API = "https://api.doitong.com/v1";
const headers = {
"Authorization": "Bearer " + process.env.DOITONG_API_KEY,
"Content-Type": "application/json",
};
// Run the model; wait up to 20 s for the finished result in the same call
let res = await fetch(API + "/run/openai/gpt-image-2.5/flare/text-to-image?wait=20", {
method: "POST",
headers,
body: JSON.stringify({
"prompt": "A handwritten recipe card titled \"Apple Pie\" on a wooden kitchen table, neat cursive ingredient list, a slice of pie on a plate beside it, cinnamon sticks, warm afternoon light, photorealistic.",
"quality": "medium"
}),
});
let request = await res.json();
if (!res.ok) throw new Error(request.error.code + ": " + request.error.message);
// Not finished yet: long-poll until it is
while (request.status === "queued" || request.status === "running") {
res = await fetch(API + "/requests/" + request.id + "?wait=20", { headers });
request = await res.json();
}
if (request.status !== "succeeded") throw new Error(JSON.stringify(request.error));
console.log(request.outputs.map((o) => o.url), request.cost.credits + " API credits ($" + request.cost.usd + ")");import os
import requests
API = "https://api.doitong.com/v1"
headers = {"Authorization": "Bearer " + os.environ["DOITONG_API_KEY"]}
payload = {
"prompt": "A handwritten recipe card titled \"Apple Pie\" on a wooden kitchen table, neat cursive ingredient list, a slice of pie on a plate beside it, cinnamon sticks, warm afternoon light, photorealistic.",
"quality": "medium",
}
# Run the model; wait up to 20 s for the finished result in the same call
r = requests.post(API + "/run/openai/gpt-image-2.5/flare/text-to-image", params={"wait": 20}, json=payload, headers=headers)
request = r.json()
if not r.ok:
raise RuntimeError(request["error"]["code"] + ": " + request["error"]["message"])
# Not finished yet: long-poll until it is
while request["status"] in ("queued", "running"):
request = requests.get(API + "/requests/" + request["id"], params={"wait": 20}, headers=headers).json()
if request["status"] != "succeeded":
raise RuntimeError(request["error"])
print([o["url"] for o in request["outputs"]], request["cost"]["credits"], "API credits", "$" + request["cost"]["usd"])# 1. Connect once (Claude Code; Cursor, VS Code, Claude Desktop: https://doitong.com/it/developers/docs/mcp)
claude mcp add --transport http doitong-models https://api.doitong.com/v1/mcp \
--header "Authorization: Bearer $DOITONG_API_KEY"
# 2. Your agent calls the "run" tool with:
{
"model_id": "openai/gpt-image-2.5/flare/text-to-image",
"input": {
"prompt": "A handwritten recipe card titled \"Apple Pie\" on a wooden kitchen table, neat cursive ingredient list, a slice of pie on a plate beside it, cinnamon sticks, warm afternoon light, photorealistic.",
"quality": "medium"
}
}Chiama il modello GPT Image 2.5 Text to Image (openai/gpt-image-2.5/flare/text-to-image) tramite Doitong API. Documentazione per gli agenti: https://doitong.com/it/developers/models/openai/gpt-image-2.5/flare/text-to-image.md
POST https://api.doitong.com/v1/run/openai/gpt-image-2.5/flare/text-to-image?wait=20
Authorization: Bearer $DOITONG_API_KEY
Content-Type: application/json
{
"prompt": "A handwritten recipe card titled \"Apple Pie\" on a wooden kitchen table, neat cursive ingredient list, a slice of pie on a plate beside it, cinnamon sticks, warm afternoon light, photorealistic.",
"quality": "medium"
}
Se lo stato della risposta è "queued" o "running", interroga GET https://api.doitong.com/v1/requests/REQUEST_ID?wait=20 finché non diventa "succeeded"; i file si trovano in outputs[].url. POST https://api.doitong.com/v1/quote/openai/gpt-image-2.5/flare/text-to-image con lo stesso body restituisce il prezzo esatto prima dell'esecuzione.Questa richiesta: 0,013 $ 13 crediti API Esegui in questa pagina
La tua nuova chiave API. Viene mostrata solo ora ed è già presente nel codice e nel campo della chiave API qui sotto. Mantienila segreta: non inserirla mai nel codice eseguito in un browser.
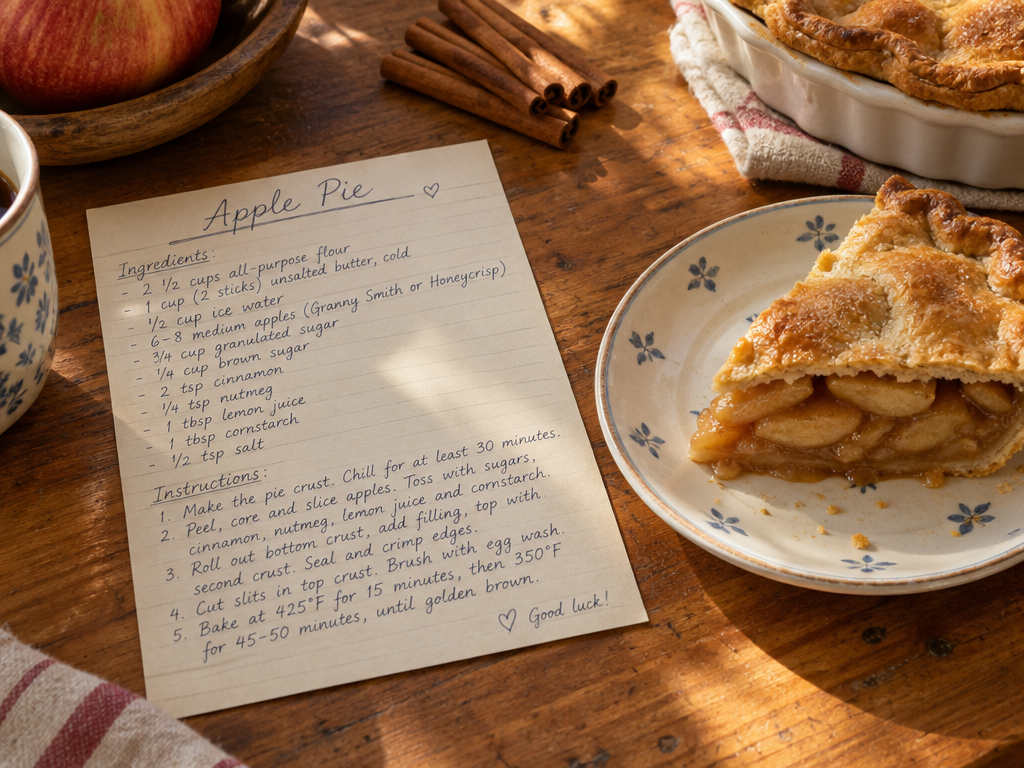
I controlli vengono generati dallo schema del modello. Il codice e il prezzo si aggiornano mentre li modifichi.
/run/openai/gpt-image-2.5/flare/text-to-image?wait=20
preventivo → 0,013 $
# Run the model; wait up to 20 s for the finished result in the same call
curl -X POST "https://api.doitong.com/v1/run/openai/gpt-image-2.5/flare/text-to-image?wait=20" \
  -H "Authorization: Bearer $DOITONG_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "prompt": "A handwritten recipe card titled \"Apple Pie\" on a wooden kitchen table, neat cursive ingredient list, a slice of pie on a plate beside it, cinnamon sticks, warm afternoon light, photorealistic.",
    "quality": "medium"
  }'

# Still "queued" or "running"? Poll with the id from the response:
curl "https://api.doitong.com/v1/requests/REQUEST_ID?wait=20" \
  -H "Authorization: Bearer $DOITONG_API_KEY"
const API = "https://api.doitong.com/v1";
const headers = {
"Authorization": "Bearer " + process.env.DOITONG_API_KEY,
"Content-Type": "application/json",
};
// Run the model; wait up to 20 s for the finished result in the same call
let res = await fetch(API + "/run/openai/gpt-image-2.5/flare/text-to-image?wait=20", {
method: "POST",
headers,
body: JSON.stringify({
"prompt": "A handwritten recipe card titled \"Apple Pie\" on a wooden kitchen table, neat cursive ingredient list, a slice of pie on a plate beside it, cinnamon sticks, warm afternoon light, photorealistic.",
"quality": "medium"
}),
});
let request = await res.json();
if (!res.ok) throw new Error(request.error.code + ": " + request.error.message);
// Not finished yet: long-poll until it is
while (request.status === "queued" || request.status === "running") {
res = await fetch(API + "/requests/" + request.id + "?wait=20", { headers });
request = await res.json();
}
if (request.status !== "succeeded") throw new Error(JSON.stringify(request.error));
console.log(request.outputs.map((o) => o.url), request.cost.credits + " API credits ($" + request.cost.usd + ")");import os
import requests
API = "https://api.doitong.com/v1"
headers = {"Authorization": "Bearer " + os.environ["DOITONG_API_KEY"]}
payload = {
"prompt": "A handwritten recipe card titled \"Apple Pie\" on a wooden kitchen table, neat cursive ingredient list, a slice of pie on a plate beside it, cinnamon sticks, warm afternoon light, photorealistic.",
"quality": "medium",
}
# Run the model; wait up to 20 s for the finished result in the same call
r = requests.post(API + "/run/openai/gpt-image-2.5/flare/text-to-image", params={"wait": 20}, json=payload, headers=headers)
request = r.json()
if not r.ok:
raise RuntimeError(request["error"]["code"] + ": " + request["error"]["message"])
# Not finished yet: long-poll until it is
while request["status"] in ("queued", "running"):
request = requests.get(API + "/requests/" + request["id"], params={"wait": 20}, headers=headers).json()
if request["status"] != "succeeded":
raise RuntimeError(request["error"])
print([o["url"] for o in request["outputs"]], request["cost"]["credits"], "API credits", "$" + request["cost"]["usd"]){
"jsonrpc": "2.0",
"id": 1,
"method": "tools/call",
"params": {
"name": "run",
"arguments": {
"model_id": "openai/gpt-image-2.5/flare/text-to-image",
"input": {
"prompt": "A handwritten recipe card titled \"Apple Pie\" on a wooden kitchen table, neat cursive ingredient list, a slice of pie on a plate beside it, cinnamon sticks, warm afternoon light, photorealistic.",
"quality": "medium"
},
"wait_seconds": 20
}
}
}La tua chiave rimane in questo browser: viene inviata solo al Doitong API e salvata in localStorage solo se selezioni Ricorda. Ottieni una chiave API
Lavori pubblici creati con GPT Image 2.5 dalla community di Doitong. Riutilizza un prompt con un clic.

Keep architecture unchanged. Photorealistic cinematic POV shot from a child riding a scooter through a modern residential park, clean late morning sunlight with soft upper side-backlight, ARRI Alexa 35, Leica Summilux-C 28mm lens, Black Pro Mist 1/8, subtle handheld inertia, natural optical...
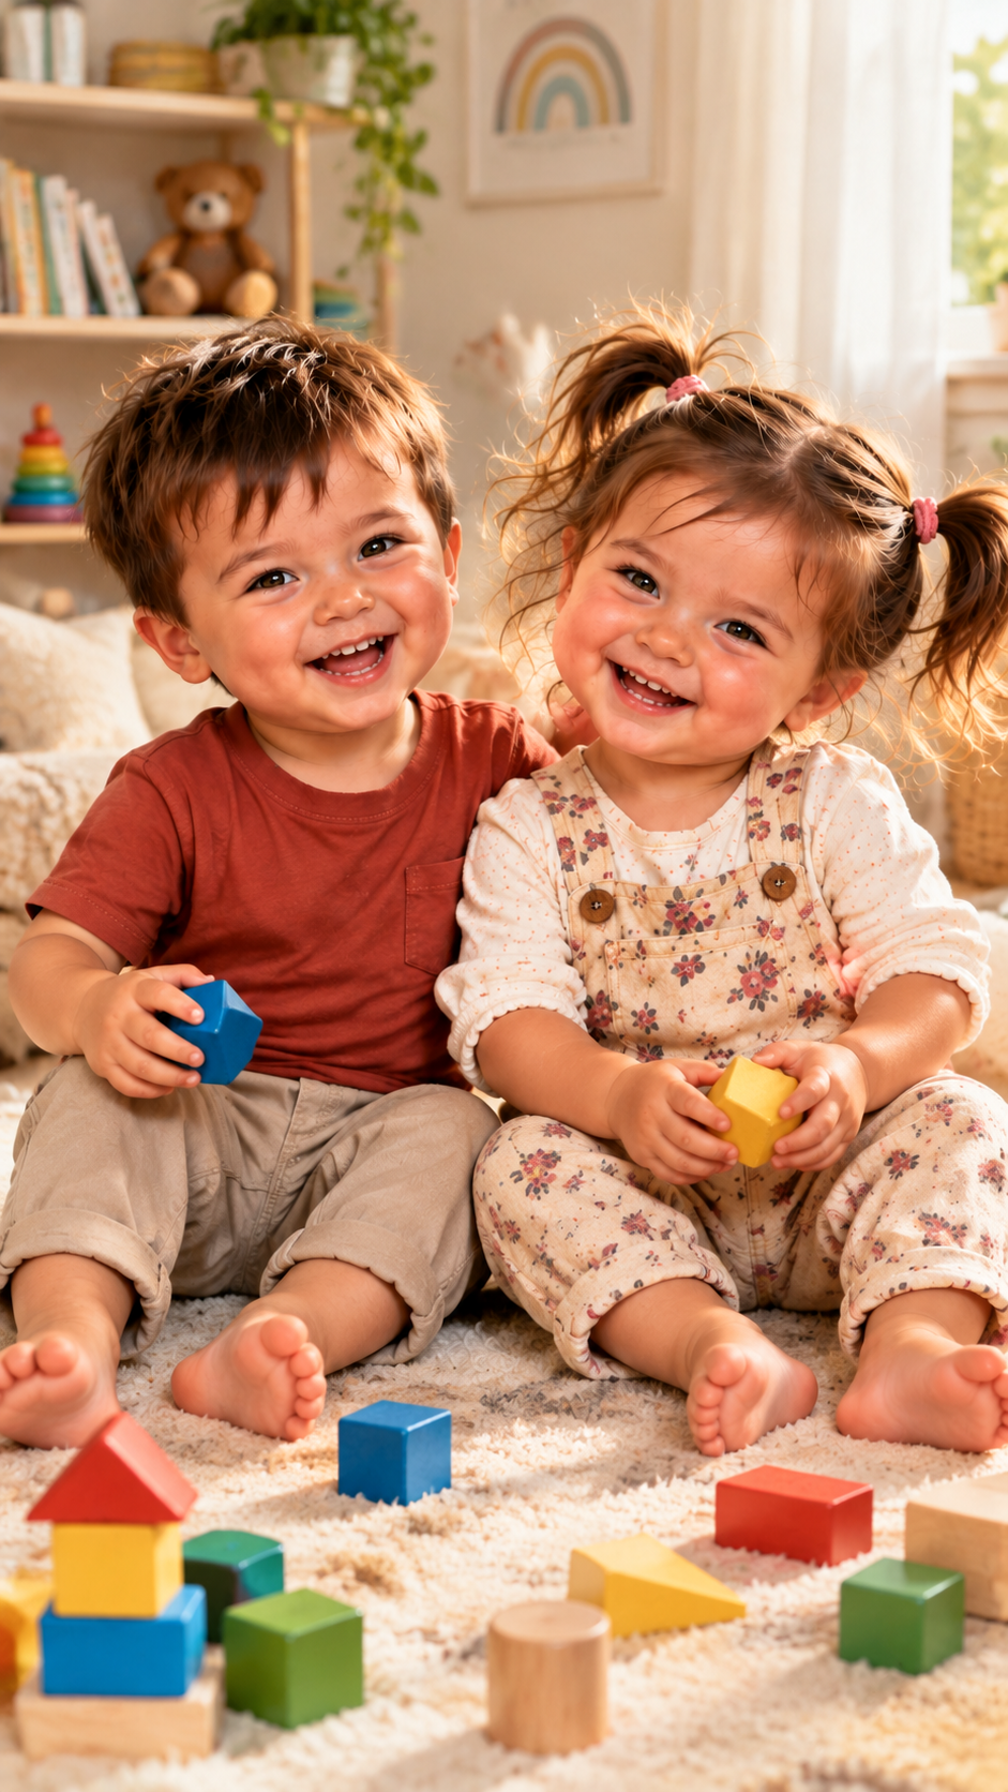
Art style: Фотореалистичная семейная комедия, максимальный фотореализм, естественные движения малышей, выразительная мимика, кинематографическая съёмка, вирусный короткий визуальный юмор без диалогов. Внешность Лео и Мии сохраняется неизменной во всех сериях.. Лео и Мия сидят вместе на мягком...
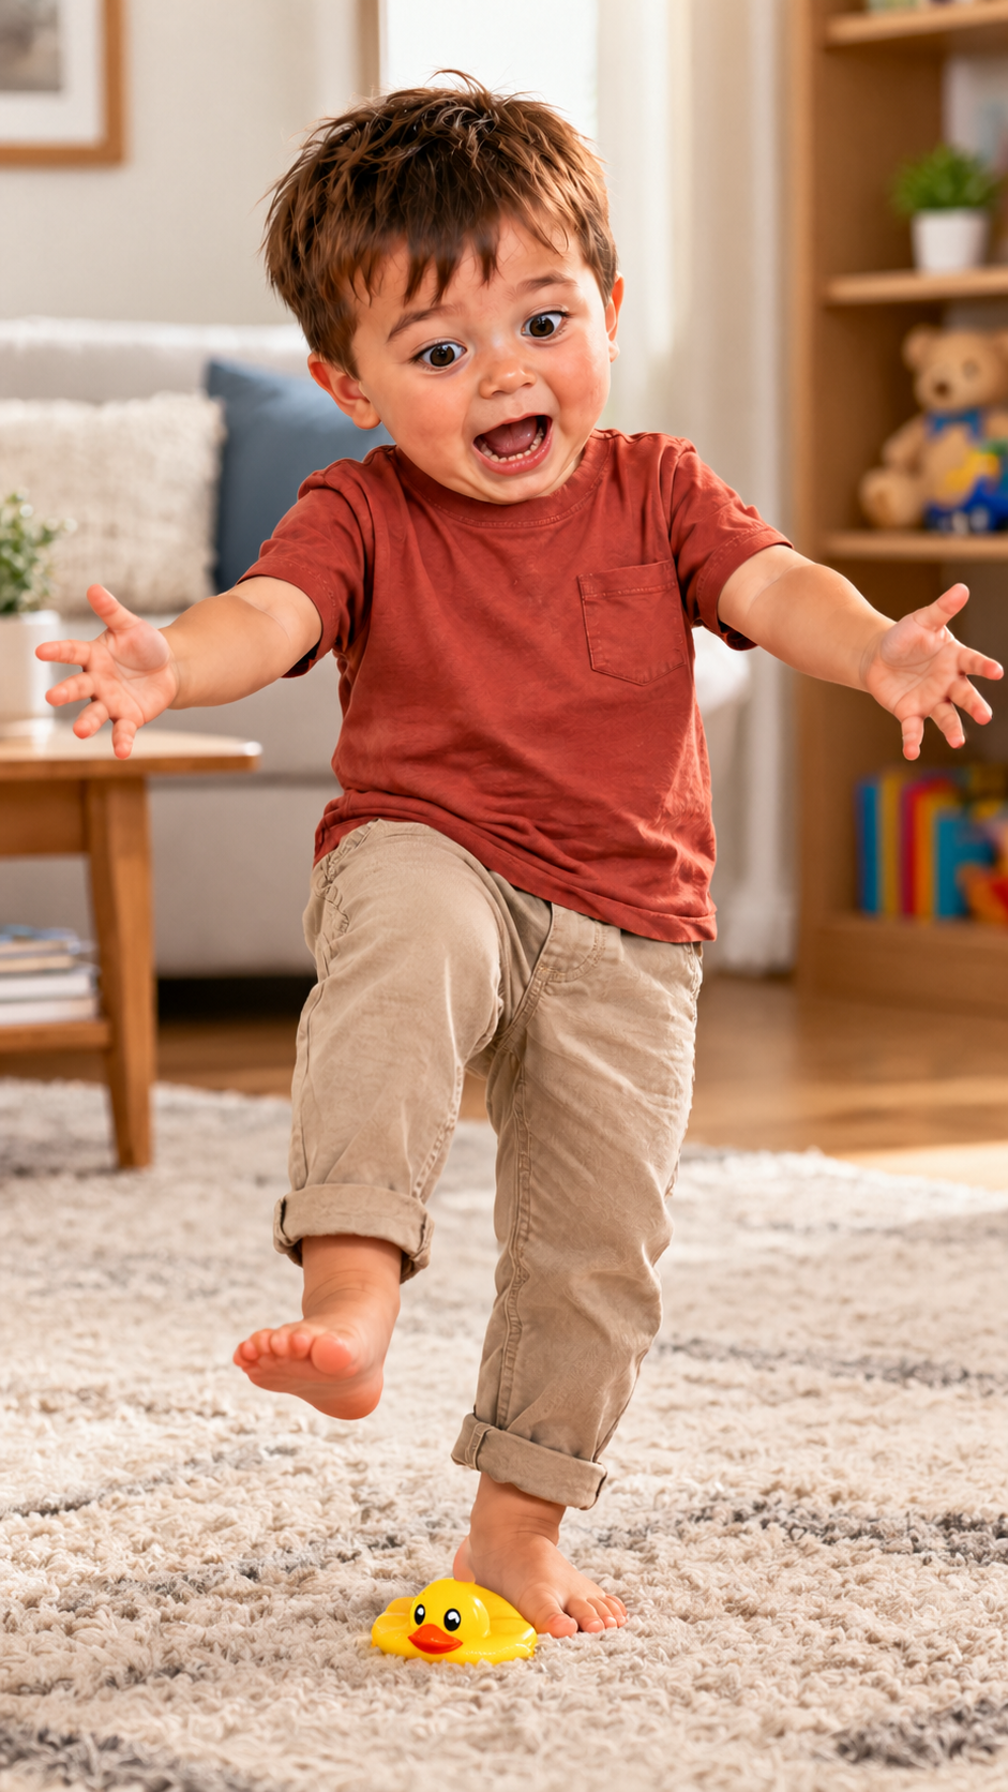
Art style: Фотореалистичная семейная комедия, максимальный фотореализм, естественные движения малышей, выразительная мимика, кинематографическая съёмка, вирусный короткий визуальный юмор без диалогов. Внешность Лео и Мии сохраняется неизменной во всех сериях.. Лео наступает босой ногой на...
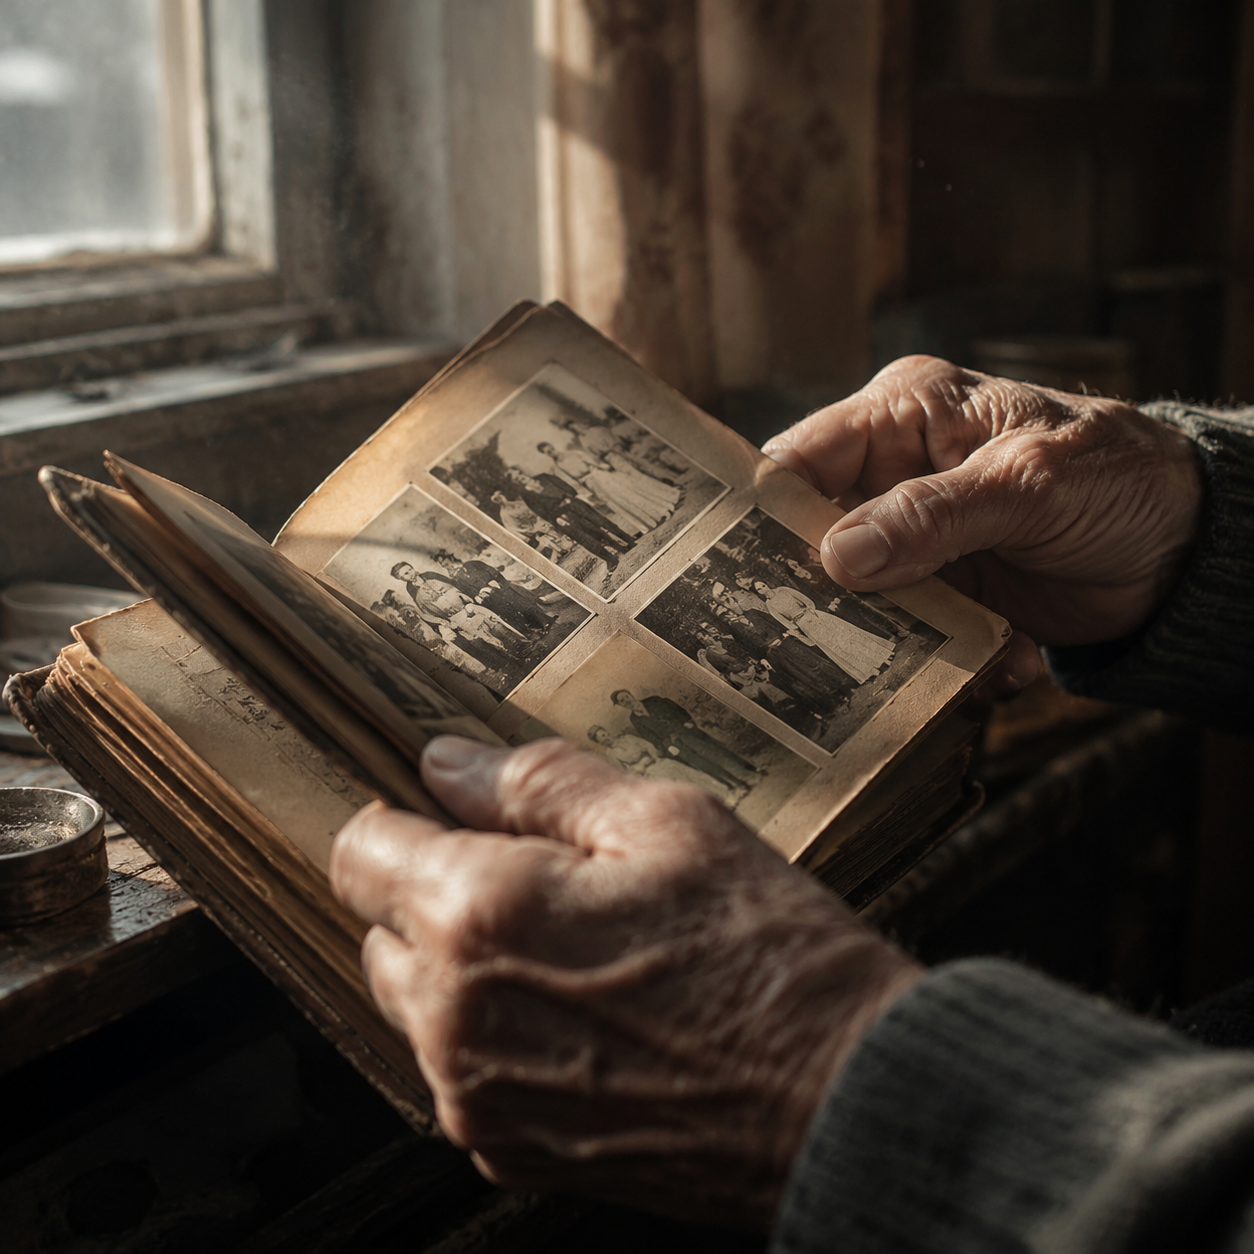
Крупный план рук пожилого мужчины, бережно держащего старый фотоальбом. Он медленно перелистывает пожелтевшие страницы с выцветшими семейными фотографиями. Мягкий тёплый свет из окна, видимые детали возрастной кожи и фактуры потёртой обложки, пылинки в воздухе, спокойная камерная атмосфера,...
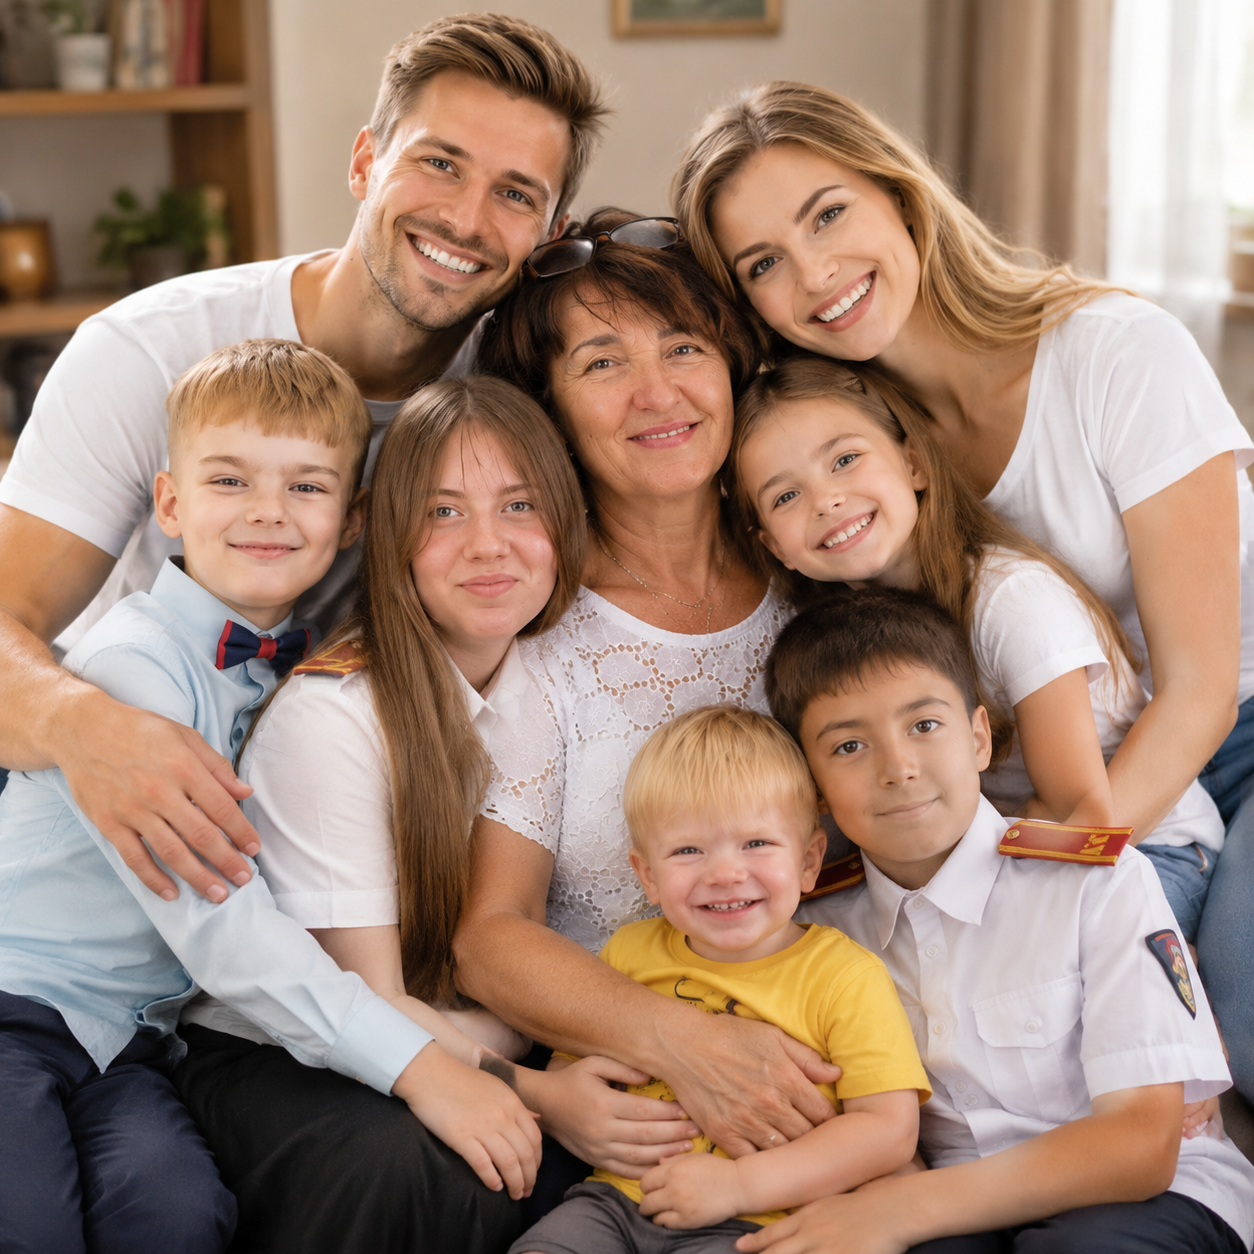
Создай реалистичную, тёплую семейную фотографию, используя обе загруженные фотографии как визуальные референсы для внешности людей и общего стиля. Изобрази бабушку в центре, а членов семьи вокруг неё — все нежно обнимают бабушку и друг друга, прижавшись плечами, с искренними улыбками и выражением...
Отредактируй загруженное изображение, сохранив стиль референса максимально точно: тот же шрифт и характер букв, цвет, оформление, композиционную эстетику и визуальное настроение. Добавь надпись именно на кириллице и ровно в таком написании: «Адрес: Төле би 40 / Самал 22А (7 мкр)». Размести весь...
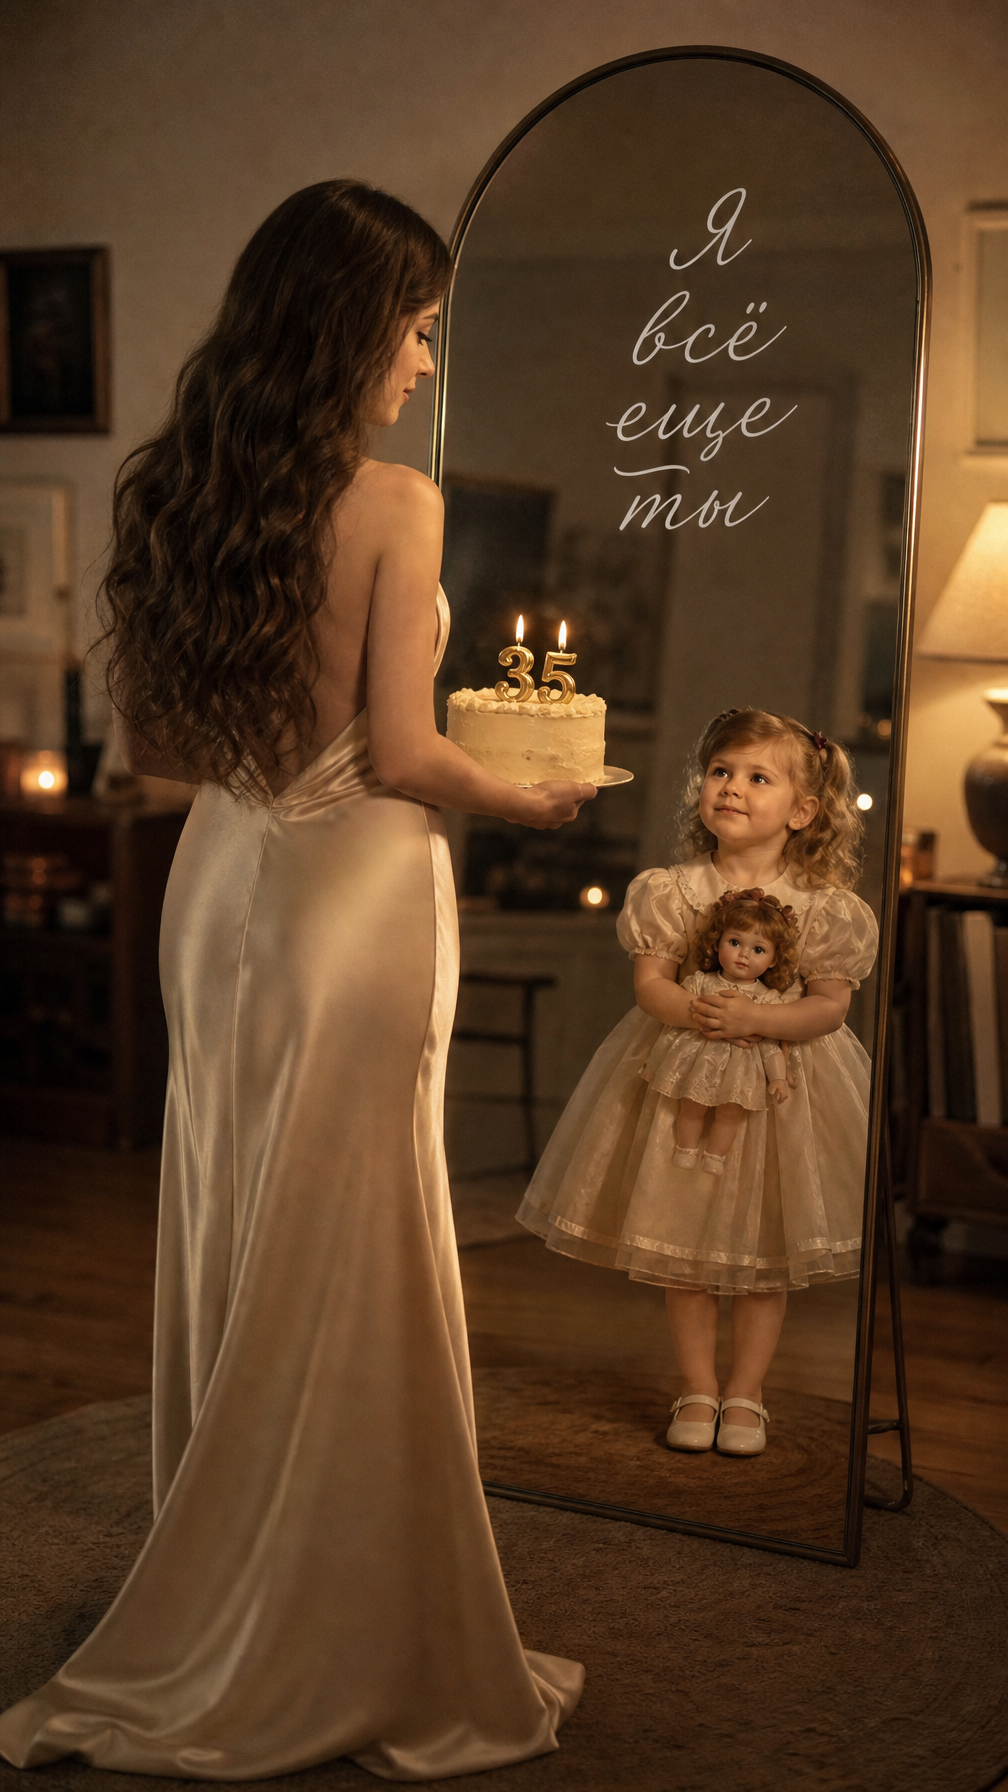
Создай не меняя черты лица. Фотореалистичный винтажный cinematic portrait. В кадре большое напольное зеркало в тонкой арочной раме. Спиной к камере у зеркала стоит взрослая девушка-, корпус развёрнут к своему отражению, голова слегка повёрнута в профиль, взгляд направлен в зеркало на свою...
Используй загруженное изображение как референс стиля и создай изображение с единственной надписью: «YERSAY ӨНІМДЕРІ ТАРАЗ ҚАЛАСЫНДА». Напиши весь текст ровно в 2 строки: в первой строке слова «YERSAY ӨНІМДЕРІ» рядом друг с другом, во второй строке — «ТАРАЗ ҚАЛАСЫНДА». Сохрани максимально похожими...
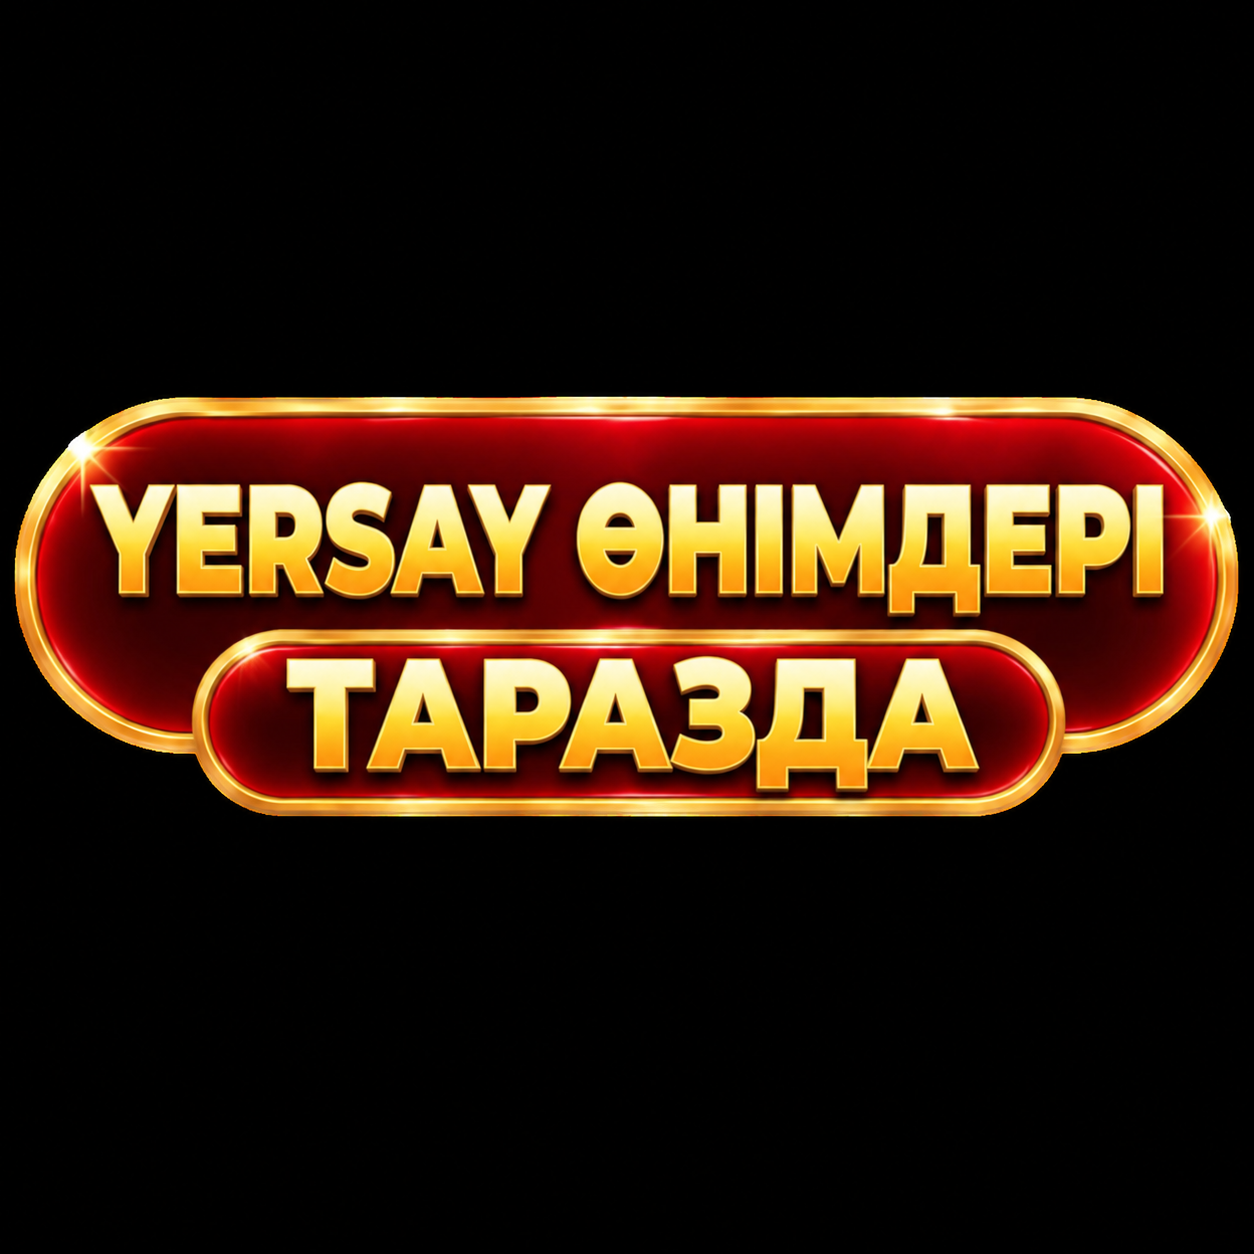
Используй загруженное изображение как референс стиля и создай изображение с единственной надписью: «YERSAY ӨНІМДЕРІ ТАРАЗДА». Напиши весь текст в 2 строки, слова YERSAY ӨНІМДЕРІ рядом друг с другом, ТАРАЗДА перенеси на вторую строку. Сохрани максимально похожими на референс стиль букв,...
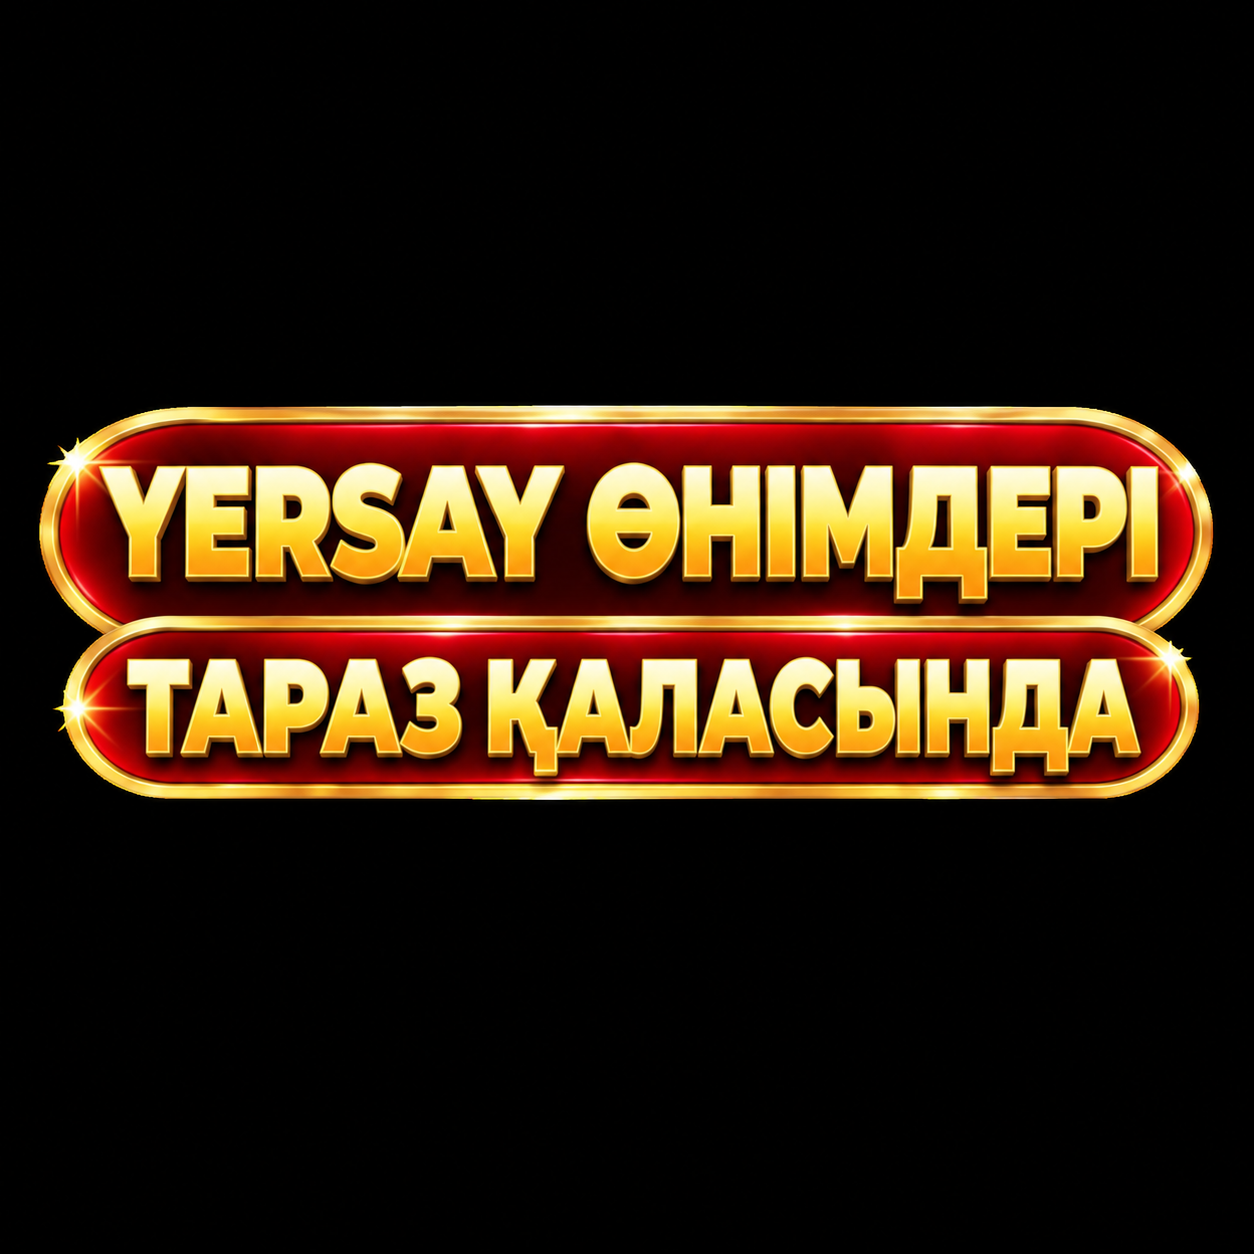
Используй загруженное изображение как референс стиля и создай изображение с единственной надписью: «YERSAY ӨНІМДЕРІ ТАРАЗ ҚАЛАСЫНДА». Напиши весь текст ровно в 2 строки: в первой строке — «YERSAY ӨНІМДЕРІ», слова рядом друг с другом; во второй строке — «ТАРАЗ ҚАЛАСЫНДА». Точно сохрани написание и...
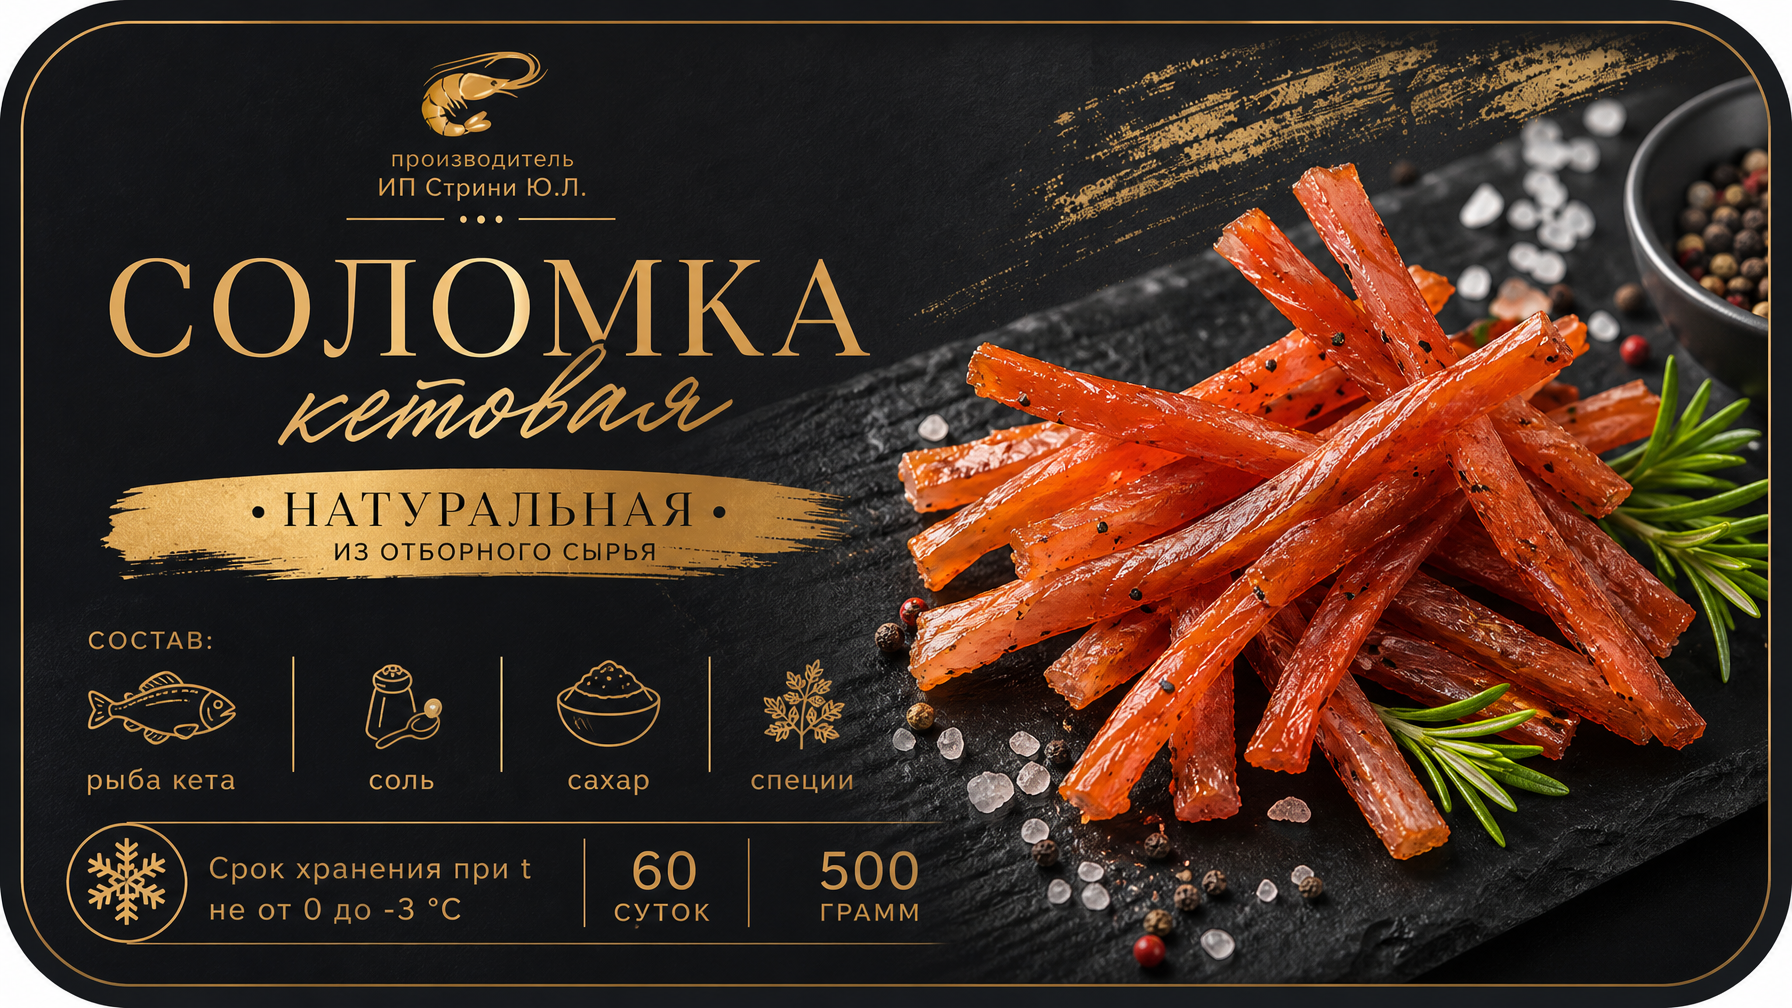
Сделай этикетку на продукцию оформленную красиво и стильно в соответствии с составом. Можешь ориентироваться по стилю на фото 1. Текст на этикетке: производитель ИП Стрини Ю.Л. «соломка кетовая», состав: рыба кета, соль, сахар, специи. Срок хранения при t не от 0 до -3 60 суток. Вес: 500гр
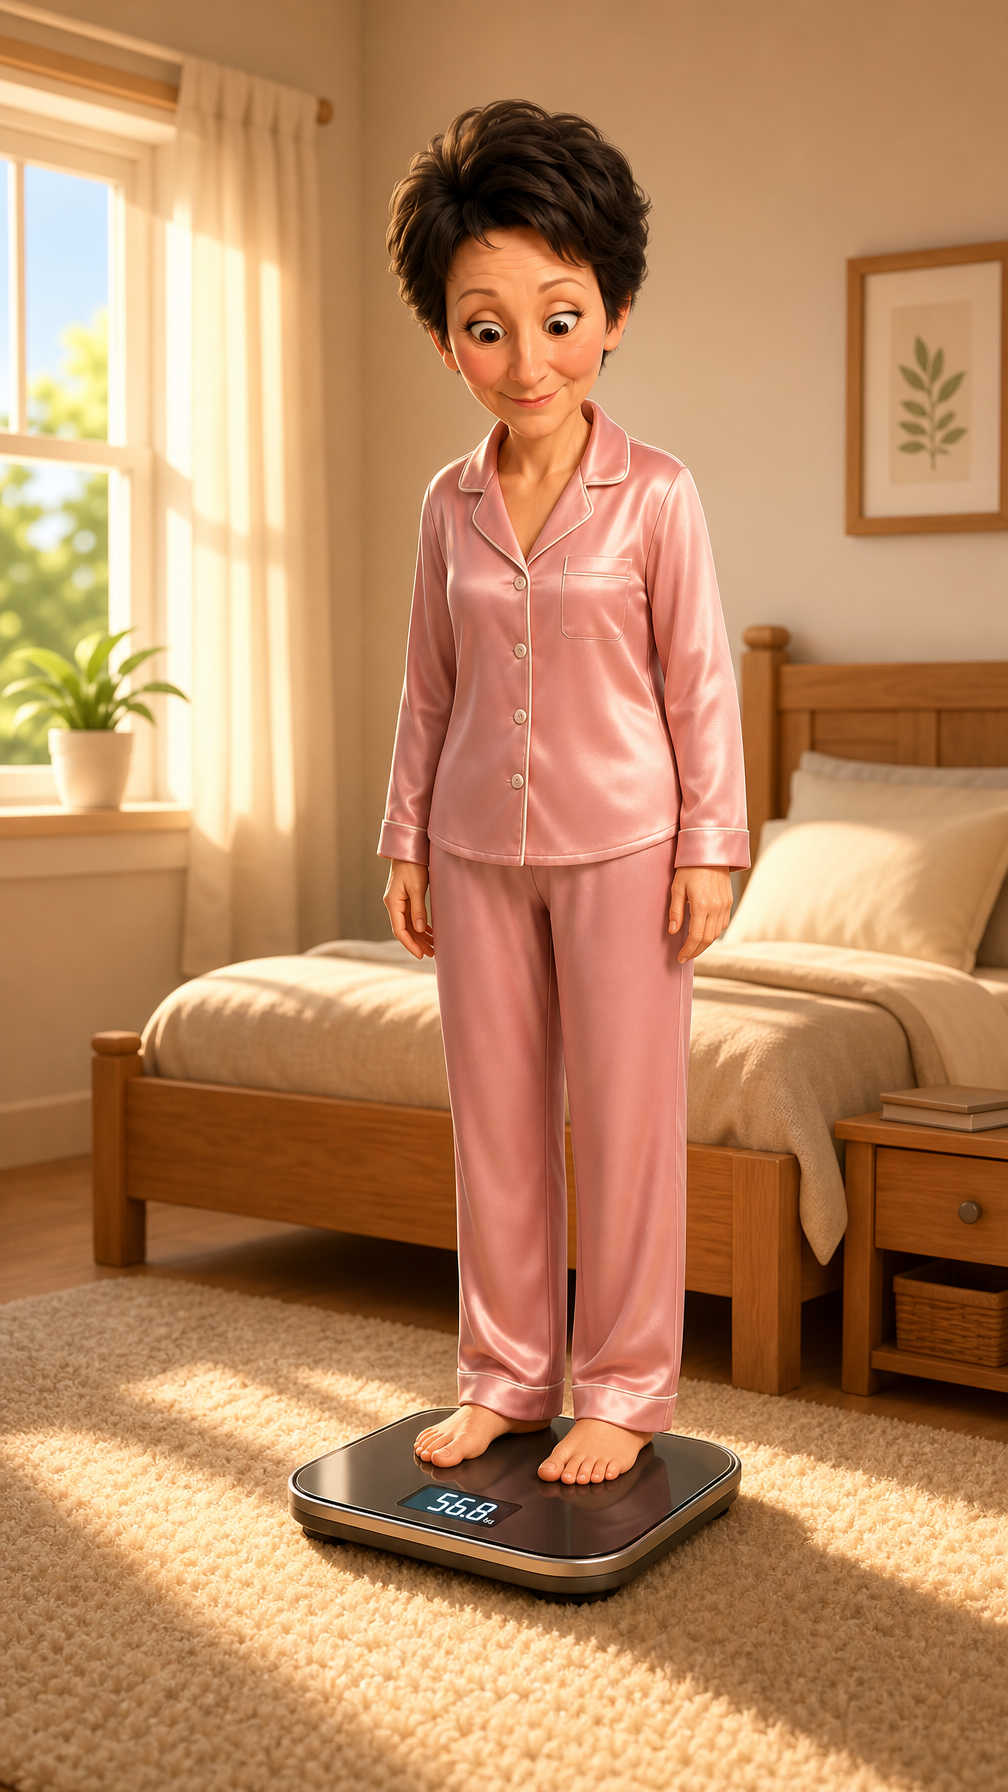
Art style: 3D stylized animation. The older woman depicted in photo 1 stands on electronic scales in a sun‑filled bedroom. Morning light pours in through the window, creating gentle shadows. She lowers her gaze — her expression is serene, yet a subtle anticipation lingers. The room is neat, with...
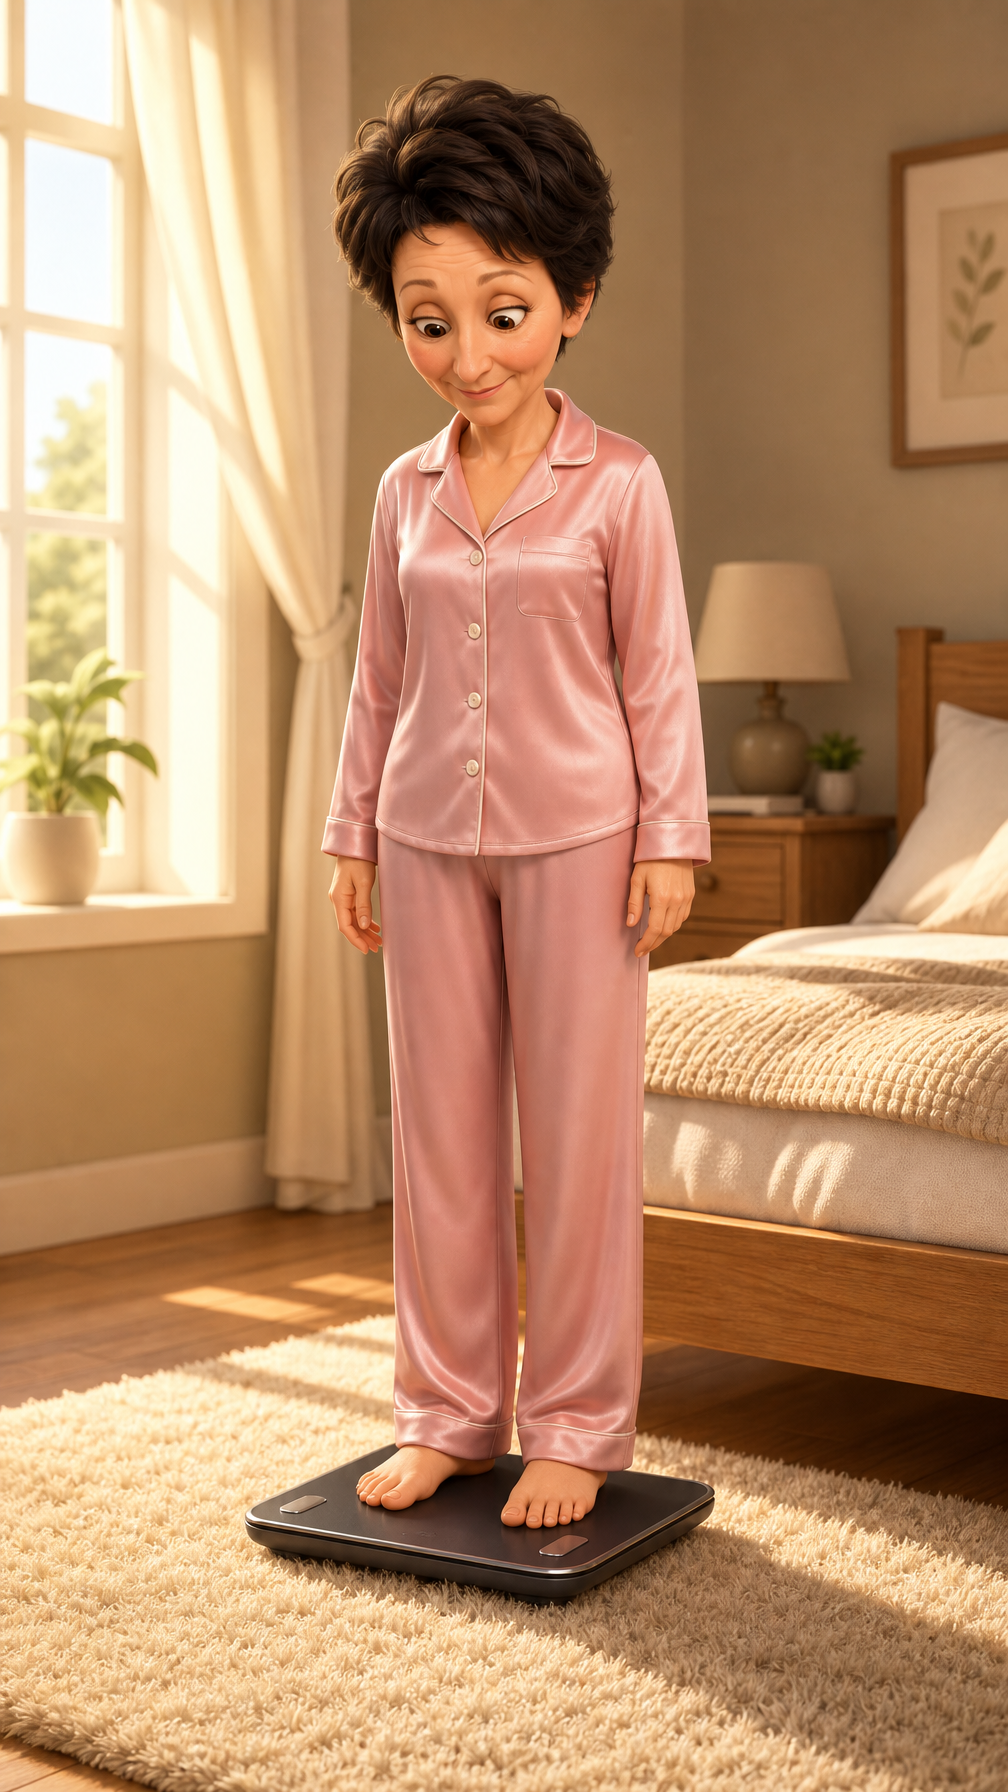
Art style: 3D stylized animation. Пожилая женщина, изображённая на фото 1, стоит на электронных весах в спальне, залитой солнцем. Утренний свет льётся через окно, создавая мягкие тени. Она опускает взгляд — выражение её лица безмятежно, но чувствуется лёгкое ожидание. Цифр на весах пока не видно....
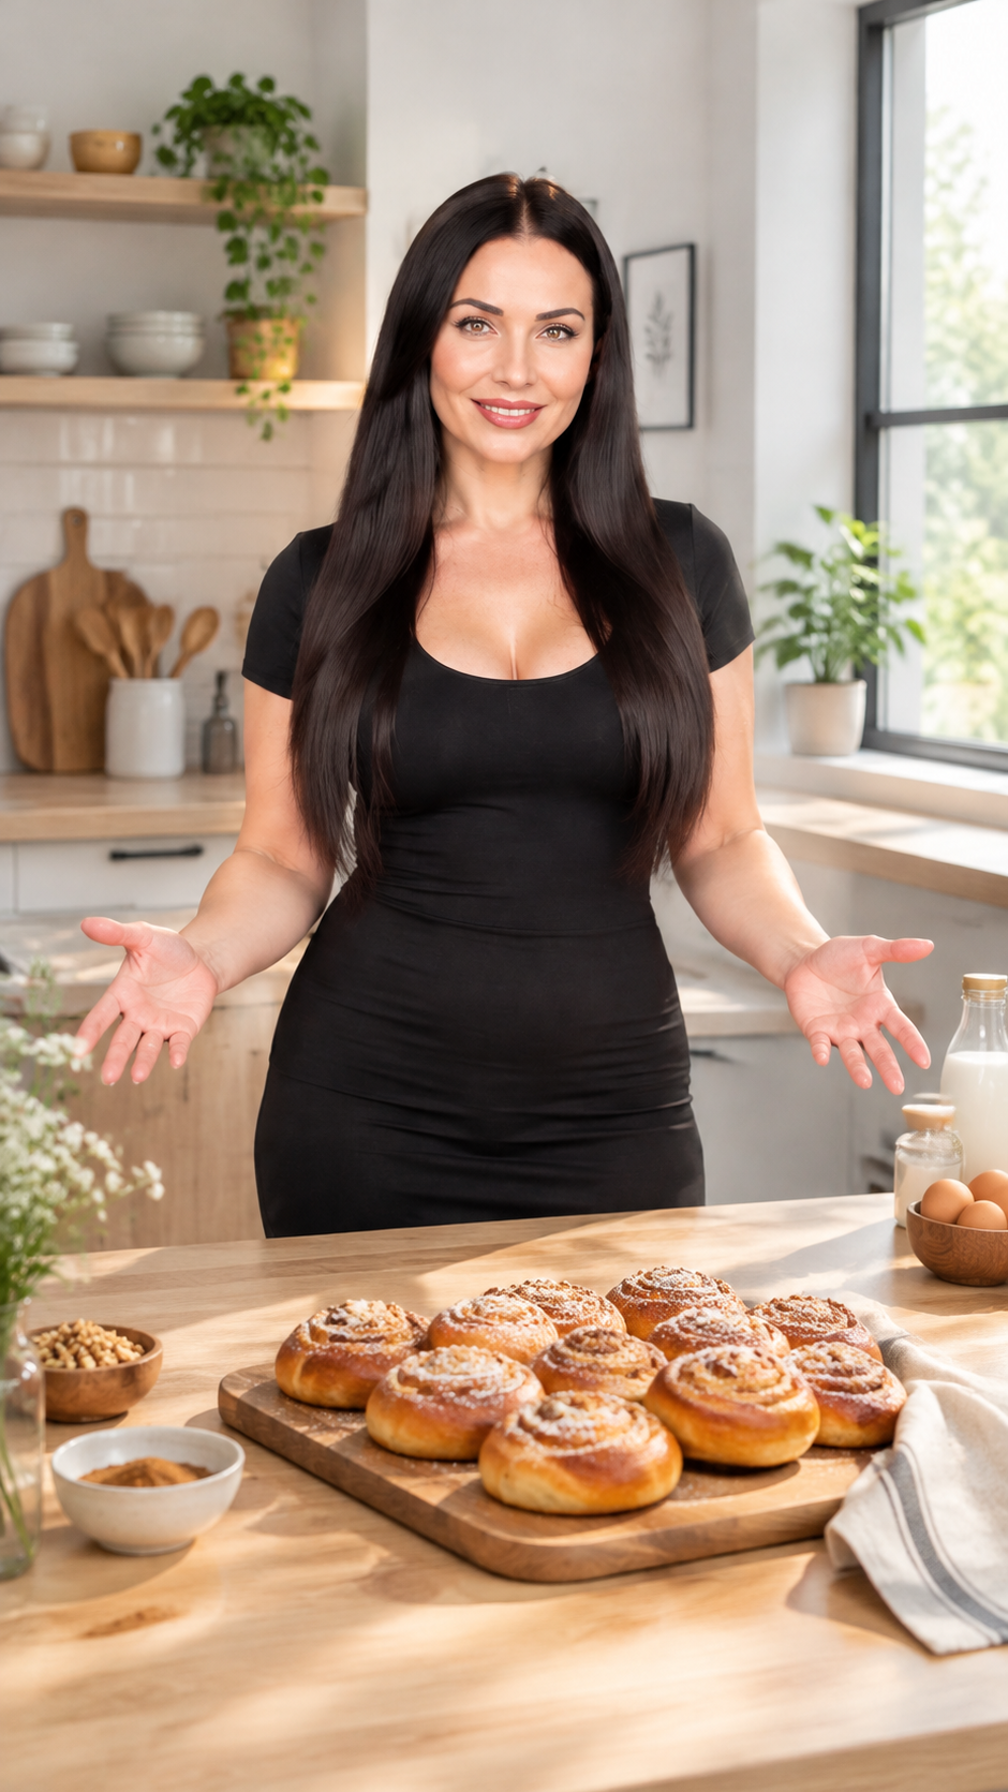
Art style: Реалистичный кулинарный блог. Ведущая стоит в центре кухни, обе руки свободно лежат на столе перед ней, где красиво разложены готовые булочки на деревянной доске. Она смотрит прямо в камеру с открытой, приглашающей улыбкой. Фон — интерьер кухни с элементами скандинавского дизайна:...
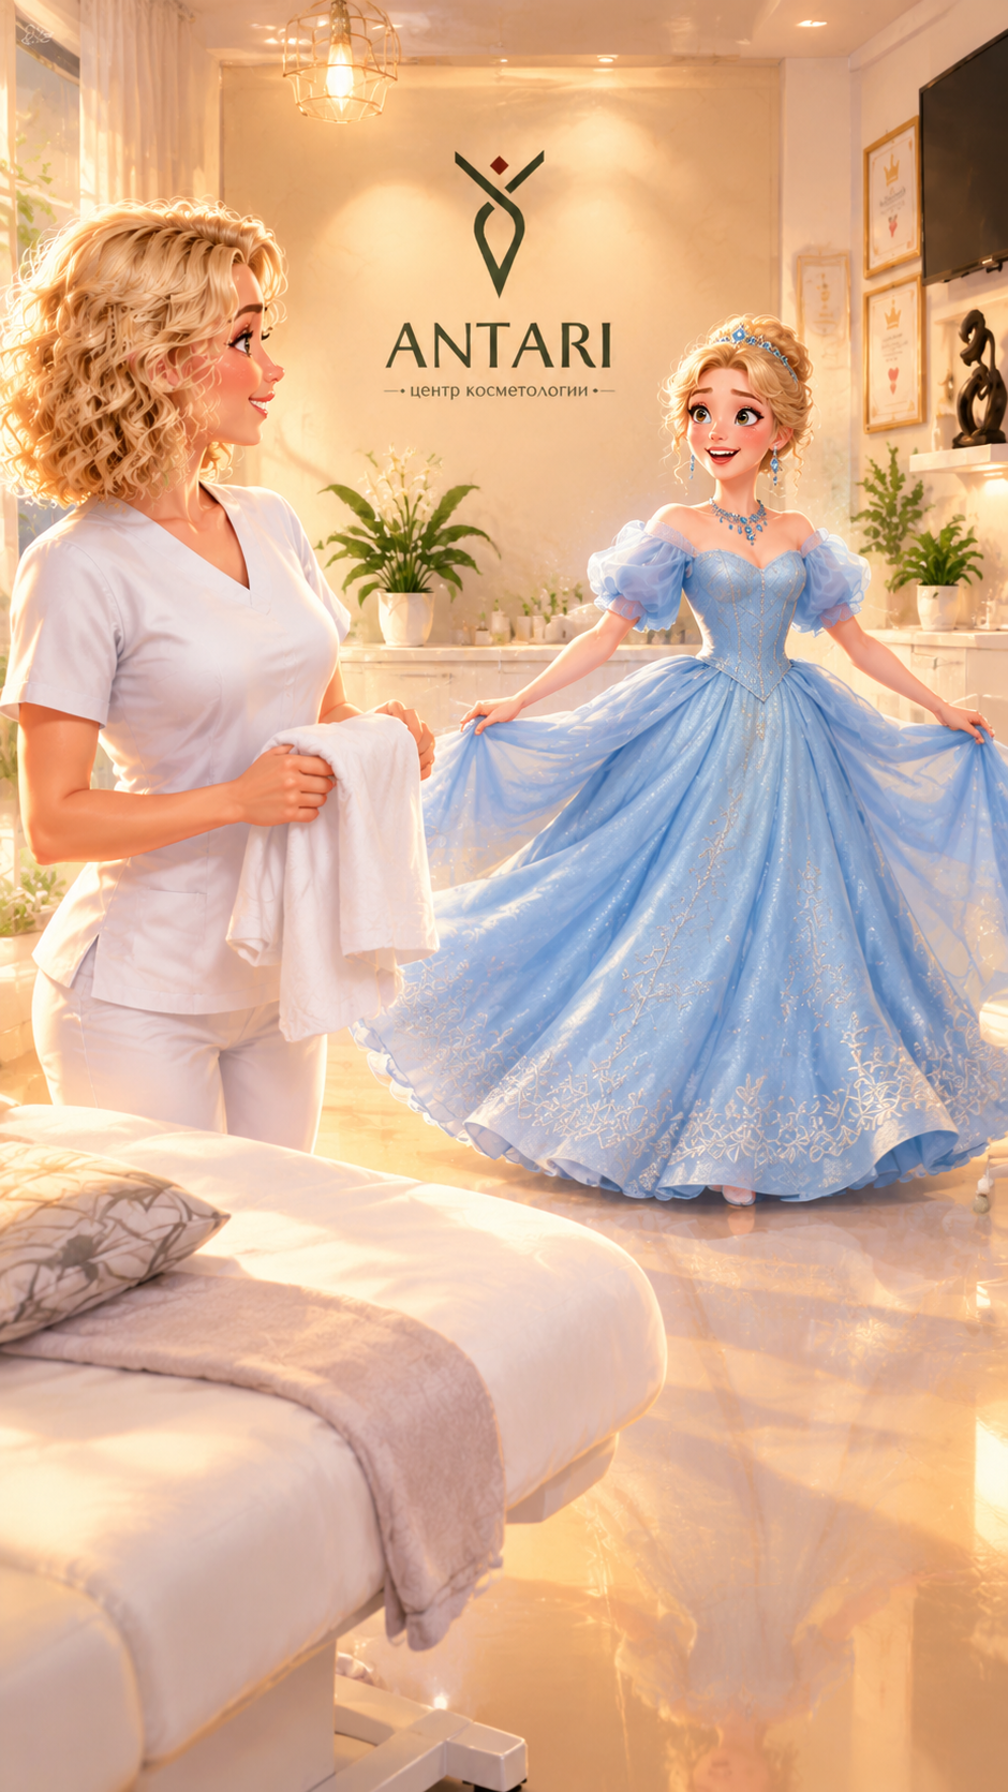
Art style: Disney-inspired. Злата standing in the middle ground; Косметолог standing in the near foreground. Open reflective floor separates the spinning Zlata from the cosmetologist by the couch. Злата is standing on glossy floor near center of the room in the middle ground in the midground....
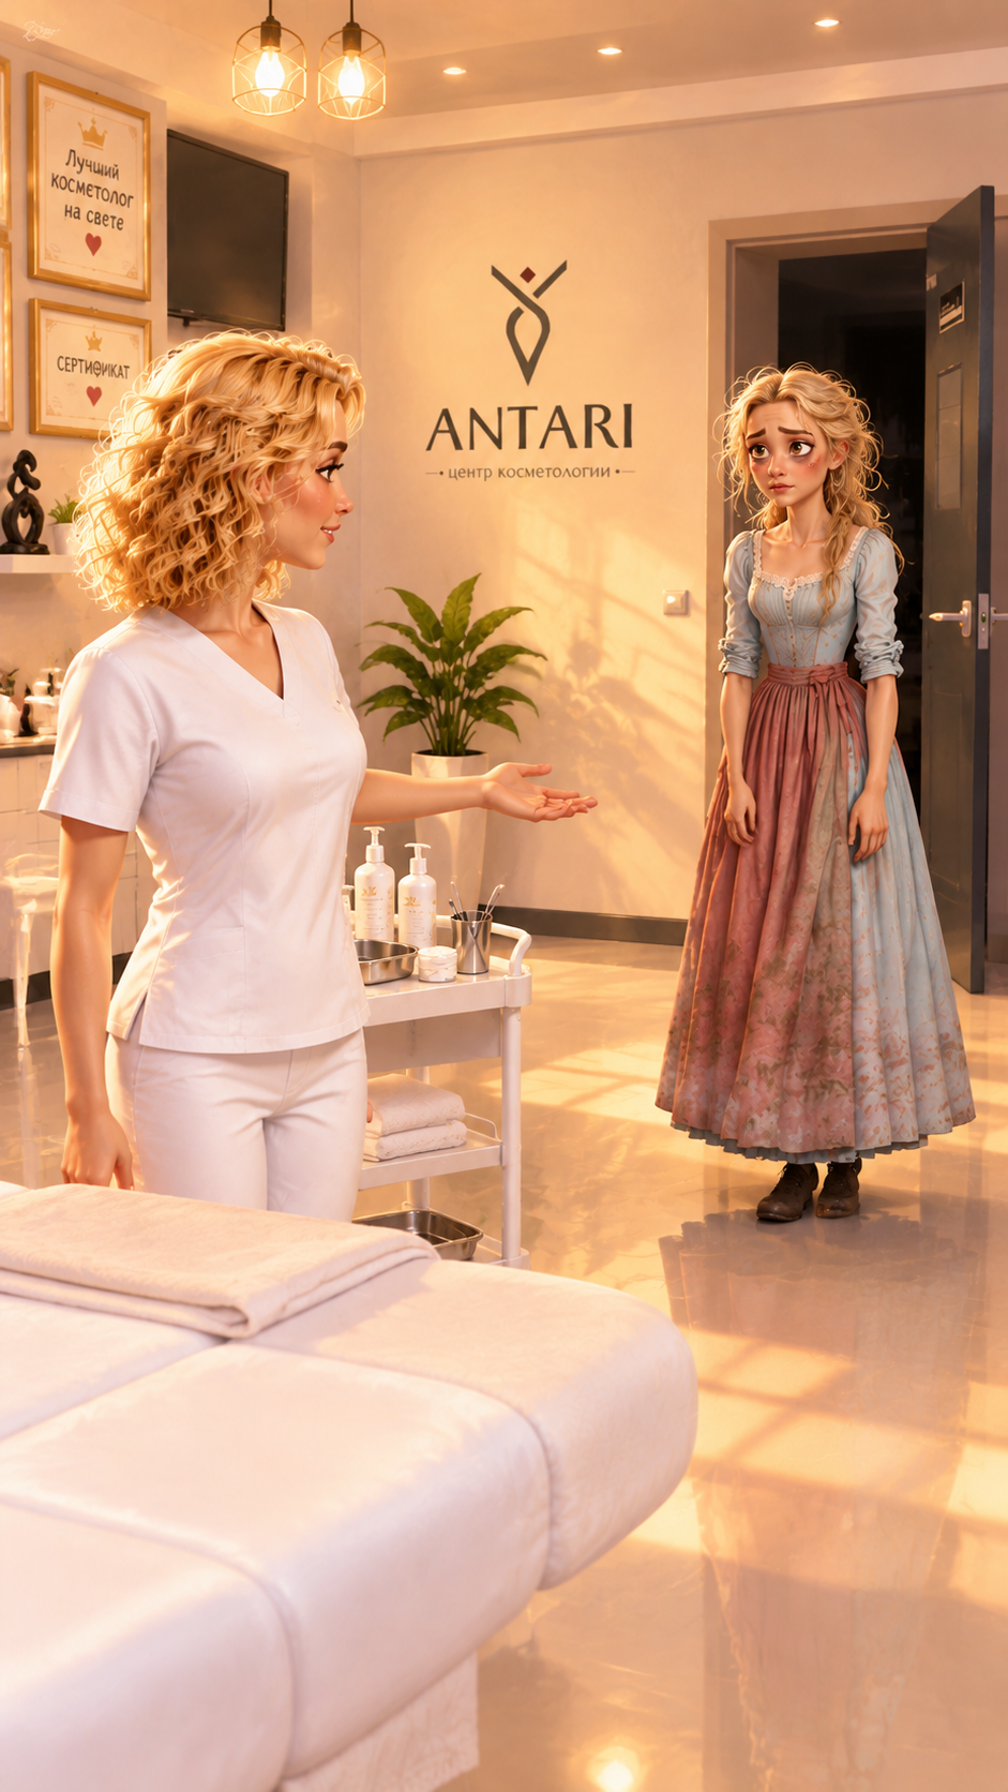
Art style: Disney-inspired. Золушка walking further back in the frame; Косметолог standing in the near foreground. The couch and strip of reflective floor separate them. Золушка is walking on glossy floor near the open doorway further back in the frame in the midground. Torso in three-quarter...
Generatore di immagini generico di OpenAI: segue istruzioni lunghe e specifiche, dispone testo e diagrammi in modo ordinato e può restituire PNG o WebP con sfondo trasparente per adesivi, icone e ritagli di prodotti. Cinque livelli di qualità bilanciano velocità e prezzo con il dettaglio. Le dimensioni arrivano a 3840 px sul lato lungo (multipli di 16, al massimo 3:1); fino a dieci immagini per richiesta.
Invia il nome canonico oppure il nome nativo, non entrambi. Nomi canonici
promptobbligatorio
image_sizefacoltativo
backgroundfacoltativo
qualityfacoltativo
num_imagesfacoltativo
num_outputs
output_formatfacoltativo
output_compressionfacoltativo
{
  "id": "req_8k2m4q7x1z9c3v5b6n0p2r4t",
  "object": "request",
  "model": "openai/gpt-image-2.5/flare/text-to-image",
  "status": "succeeded",
  "created_at": "2026-10-20T12:00:00Z",
  "started_at": "2026-10-20T12:00:02Z",
  "completed_at": "2026-10-20T12:00:09Z",
  "queue_position": null,
  "cost": {
    "credits": 13,
    "usd": "0.013",
    "charged": 13,
    "refunded": 0
  },
  "input": {
    "prompt": "A flat vector sticker of a smiling cactus wearing sunglasses, thick white outline, no background",
    "image_size": "square_hd",
    "quality": "medium",
    "background": "transparent"
  },
  "output": {
    "images": [
      {
        "url": "https://content.doitong.com/dev-api/2026/10/20/req_8k2m4q7x1z9c3v5b6n0p2r4t/0-output.jpeg",
        "content_type": "image/jpeg",
        "file_name": "0-output.jpeg",
        "file_size": 1843200,
        "width": 1024,
        "height": 768
      }
    ]
  },
  "outputs": [
    {
      "type": "image",
      "url": "https://content.doitong.com/dev-api/2026/10/20/req_8k2m4q7x1z9c3v5b6n0p2r4t/0-output.jpeg",
      "content_type": "image/jpeg",
      "file_size": 1843200,
      "width": 1024,
      "height": 768,
      "stored": true
    }
  ],
  "error": null,
  "metrics": {
    "inference_seconds": 6.8
  },
  "urls": {
    "self": "https://api.doitong.com/v1/requests/req_8k2m4q7x1z9c3v5b6n0p2r4t",
    "cancel": "https://api.doitong.com/v1/requests/req_8k2m4q7x1z9c3v5b6n0p2r4t/cancel"
  }
}
Per gli agenti AI: questa pagina in Markdown è disponibile all'indirizzo https://doitong.com/it/developers/models/openai/gpt-image-2.5/flare/text-to-image.md. Tutti i modelli e le guide: https://doitong.com/developers/llms.txt